複数の競馬指数を見比べるとき、数字の大きさより先に「同じ馬を、どの順番に評価しているか」をそろえると、違いを整理できます。順位相関は、その並び方の一致を表す道具です。高い一致は的中や利益を保証せず、低い一致も穴馬の証明にはなりません。
この記事では6頭の仮想データを使い、順位差、スピアマンの順位相関、上位3頭の重なり、同順位と欠測を別々に確認します。本文の指数は計算の練習用で、当サイトの実配信値・実在馬の能力・過去の的中成績を示しません。
先に押さえる3点
同じレース・同じ時点・同じ目的の指数を比較します。全体の順位相関と、買い目に使う上位候補の一致を分けます。一致した理由と違った理由を条件に戻して確認し、順位だけで購入を決めません。
目次
指数を順位へ直す前に比較条件をそろえる
同じ100点でも同じ能力を表すとは限らない
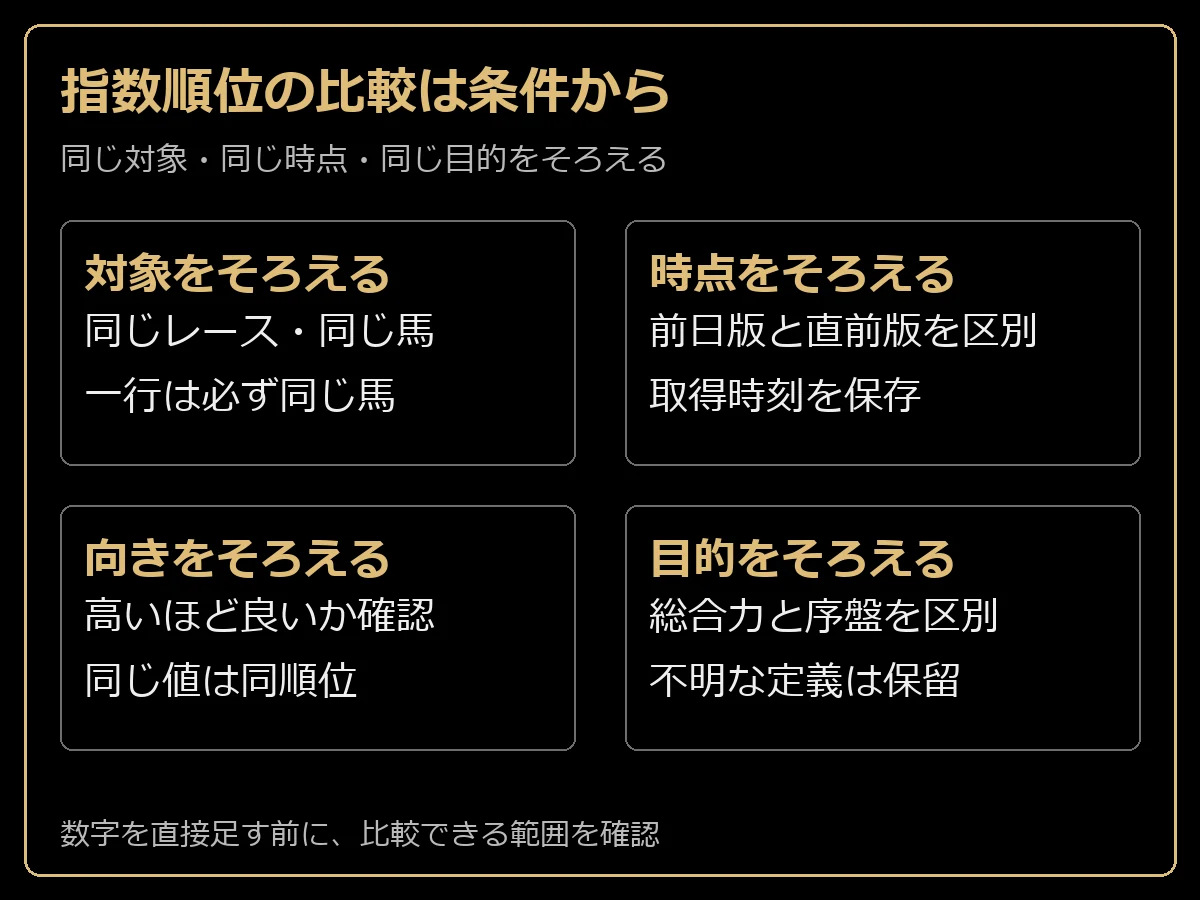
指数の数値は、基準タイム、馬場補正、集約する近走、適性の扱いによって尺度が変わります。一方の100と別の100を足して平均しても、同じ物差しを混ぜたことにはなりません。まず提供元の定義を読み、高いほど高評価なのか、低いほど高評価なのかを確認します。
例えば指数Xが近走の走破内容、指数Yが今回の序盤の位置取りを評価している場合、両者の順位が違っても矛盾とはいえません。全体能力と先行力では答えている質問が異なるためです。順位相関を出すなら、「同じ目的の評価がどこまで一致しているか」という比較の問いを先に書きます。
基礎的な尺度と補正の考え方は競馬指数の見方とスピード指数の仕組みで確認できます。本記事では指数の新しい作り方ではなく、既にある2種類の評価を照合する手順に絞ります。
同じ馬を一行に置き、順序を固定する
比較表は馬番や馬の識別子をキーにして作ります。指数Xを高い順に並べた表の隣へ、指数Yも高い順に並べた列をそのまま貼ると、別の馬同士を比較してしまいます。表の一行は必ず同じ馬であり、その行の中にXとYの値・順位を置きます。
仮想例ではA〜Fの6頭を使います。Aは馬番ではなく練習用の識別記号です。実際に記録するときは開催日、競馬場、レース番号、馬番、馬名をそろえ、同名や別開催の取り違いを避けます。馬番が確定する前に作った表は、確定後に対応を照合してください。
| 照合する項目 | そろえる内容 | そろわない場合の扱い |
|---|---|---|
| 対象レース | 開催日・場・競走番号 | 別表に分ける |
| 対象馬 | 同じ識別子で一行に対応 | 名前だけの貼り合わせを止める |
| 取得時点 | 発走前の同じ比較時刻 | 時刻差を明記する |
| 評価方向 | 高いほど良いか低いほど良いか | 順位の向きを統一する |
| 目的 | 走破内容・適性など | 異なる目的は参考比較にする |
| 対象範囲 | 出走予定全頭か一部か | 共通対象の頭数を明記する |
前日版と直前版を混ぜない
片方が前日、片方が馬体重や取消を反映した直前の評価なら、並びの変化には情報の差も含まれます。違いを計算することはできますが、「指数の設計だけが違う」という説明にはできません。両方の取得時刻と更新時刻が分かる範囲を記録します。
同じ提供元でも、公開値と更新前の保存値を比較すると版の違いが残ります。再計算された値だけで過去表を置き換えず、発走前に見られた表を保存しておくと、後で当時の判断を追えます。結果を見てから最新版の順位を採用すると、予想時点では使えなかった情報が混じることがあります。
順位差とスピアマンの順位相関を6頭で検算する
まず一頭ずつ差を確認する
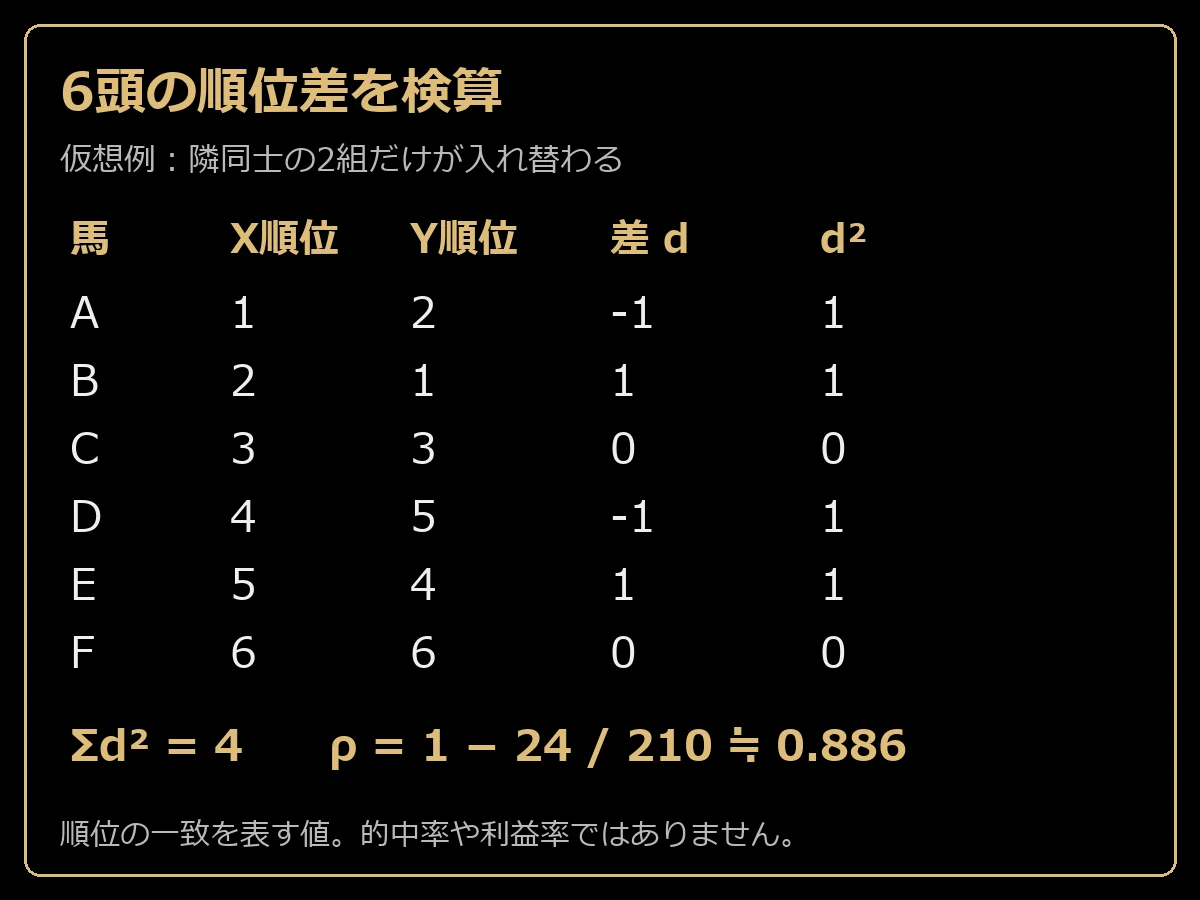
仮想の指数XはA〜Fの順に高く、指数YではAとB、DとEの評価が入れ替わっています。次の表は高い値を1位としたもので、同順位はありません。小数点以下の値の精度に意味がない場合は、提供元の表示精度を保ち、こちらで架空の桁を付け足さないようにします。
| 馬 | 指数X | X順位 | 指数Y | Y順位 | 順位差d | dの二乗 |
|---|---|---|---|---|---|---|
| A | 90 | 1 | 82 | 2 | -1 | 1 |
| B | 85 | 2 | 88 | 1 | 1 | 1 |
| C | 80 | 3 | 78 | 3 | 0 | 0 |
| D | 75 | 4 | 70 | 5 | -1 | 1 |
| E | 70 | 5 | 74 | 4 | 1 | 1 |
| F | 65 | 6 | 62 | 6 | 0 | 0 |
| 合計 | — | 21 | — | 21 | 0 | 4 |
順位差はX順位からY順位を引いています。符号はどちらを先に引くかで反転しますが、二乗差の合計は同じです。この例でBの差が1なのは、Xでは2位、Yでは1位だからです。「差がプラスなら必ず割安」という解釈はできません。
比較しているのは市場価格ではなく2種類の評価だからです。
同順位がない場合の式を使う
同じn頭に対する順位がそれぞれ1位からn位まで重ならずに付いている場合、スピアマンの順位相関は、1から「6×順位差の二乗和÷n×(nの二乗−1)」を引いて求められます。割り算の分母はn×(nの二乗−1)全体です。
掛ける順序だけを見て途中で別の割り算にしないようにしてください。
この例はn=6、二乗和=4です。分母は6×(36−1)=210、分子は6×4=24なので、1−24÷210=0.885714…となります。表示を小数第3位へ丸めれば0.886です。途中の順位差を丸める必要はなく、最後の表示だけ丸めます。
この数値が表しているのは、6頭の順序が全体としてかなり近いということです。0.886を「88.6%の的中率」「88.6%の信頼度」に読み替えることはできません。相関係数には的中率の分母も、購入金額も、払戻金も入っていません。
一致・逆転・一部入れ替えを同じ式で確かめる
全頭の順位が同じなら二乗差は全て0で、係数は1です。6頭の順位が完全に逆なら差の二乗は25、9、1、1、9、25となり、合計70です。1−6×70÷210=−1になります。今回の0.886は、その両端の間に位置しています。
| 比較する並び | YのA〜F順位 | 二乗差合計 | 順位相関 | 読めること |
|---|---|---|---|---|
| 完全一致 | 1,2,3,4,5,6 | 0 | 1.000 | 全頭の順序が同じ |
| 隣同士2組が逆 | 2,1,3,5,4,6 | 4 | 0.886 | 局所的な違いがある |
| 上位2頭だけ同じ | 1,2,6,5,4,3 | 20 | 0.429 | 下位の順序で差が大きい |
| 完全逆順 | 6,5,4,3,2,1 | 70 | -1.000 | 全頭の順序が逆 |
順位相関の基本は、元の値をそれぞれ順位に変え、その順位の相関を見る方法です。同順位は平均順位に置き換えるという扱いも含め、統計的な定義はNISTの順位相関の資料を確認しています。ここから先の馬や指数の表は当サイト独自の練習例です。
全体の一致と上位候補の一致を分けて読む
買い目に使う範囲を別の表にする
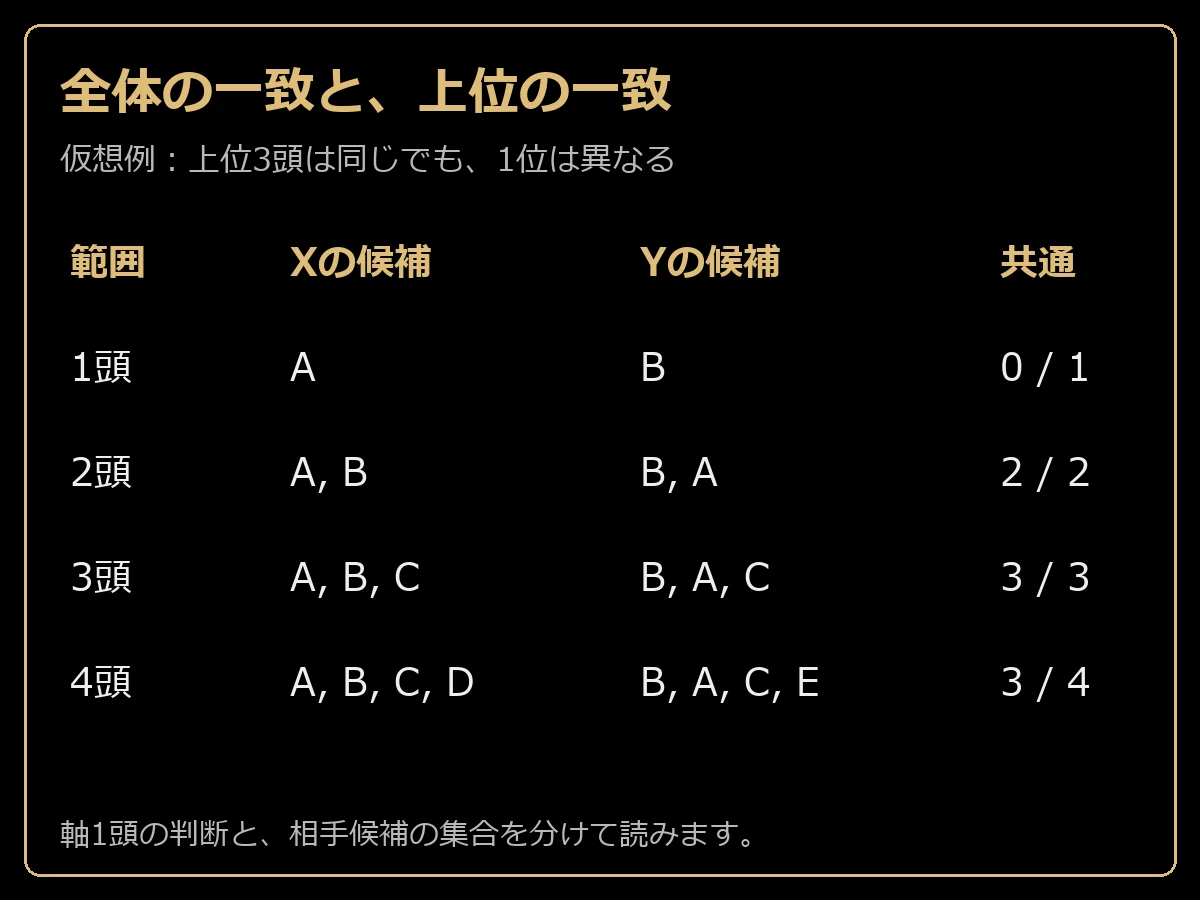
先ほどの例で、Xの上位3頭はA・B・C、Yの上位3頭もB・A・Cです。順序は異なりますが、上位3頭の集合は同じです。「上位3頭のうち共通する頭数÷3」という簡単な重複率なら3÷3=100%になります。
全体の順位相関0.886と、上位候補の重複率100%は矛盾しません。
一方、軸を1頭に絞ると、Xの1位はA、Yの1位はBです。「軸を1頭にする」という目的では、AとBの入れ替わりが大きな意味を持ちます。全体では近いからといって、軸の結論まで同じとは限りません。順位相関と一緒に、どの範囲で選択が変わるかを示すことが必要です。
| 判断する範囲 | Xの候補 | Yの候補 | 共通頭数 | この例の重複率 |
|---|---|---|---|---|
| 上位1頭 | A | B | 0 | 0% |
| 上位2頭 | A,B | B,A | 2 | 100% |
| 上位3頭 | A,B,C | B,A,C | 3 | 100% |
| 上位4頭 | A,B,C,D | B,A,C,E | 3 | 75% |
| 上位5頭 | A,B,C,D,E | B,A,C,E,D | 5 | 100% |
順位の一致と差の大きさは別の情報
指数Xが90、89、88と並び、指数Yが90、70、50と並んでいれば、上位3頭の順序は同じです。しかし、差の大きさは大きく違います。順位だけに変換すると、この差は捨てられます。順位相関は異なる尺度を直接足さずに比べられる反面、接戦なのか突出なのかを表しません。
そのため順位表の隣には元の値を残します。ただし異なる提供元の差をそのまま比較するのではなく、各指数の中で1位と2位がどれほど離れているか、その差が普段の変動に比べて大きいかを見る補助に使います。尺度が不明なら「数値差の比較は保留」として、順位と条件だけ確認します。
近走の集約方法で順位が動く問題は指数の平均値と最高値と重み付け・加重平均で扱っています。順位が違ったときは、まず採用した走数や重みが異なるかを確認すると、単純な多数決より理由を追いやすくなります。
一致した指数の数を独立した根拠の数にしない
3種類の指数が同じ馬を1位にしていても、同じ走破時計や似た馬場補正を主材料にしているなら、共通の情報を繰り返し見ている可能性があります。3票だから独立した3つの証拠がある、とは限りません。算出の詳細が公開されていなければ、独立性の判断も保留します。
仮想的に、XとYは直近走の時計重視、Zは距離適性重視だったとします。XとYの一致を二重に加点する前に、両方が同じ近走の好時計を評価していないかを見ます。Zだけ順位が低いなら、全体能力を否定しているのか、今回の距離への懸念なのかを分けます。
目的が違う情報を同じ投票箱へ入れないことが大切です。
順位が割れた馬は、理由を確認する候補
順位差が大きい馬を自動的に穴馬に選ぶのではなく、距離、馬場、近走の集約、欠測、更新時刻のどこで差が生まれたかを調べます。説明できない差は、無理に結論へ変えずに保留します。
上位候補の重複にも分母がある
上位3頭の重複率は、双方が3頭ずつ選べる場合なら共通頭数を3で割る方法が分かりやすいですが、片方が同点で4頭になる場合は別の規則が必要です。上位3位までとするのか、必ず3頭に切るのかを先に決めます。後から当たった馬を含むように境界を動かしてはいけません。
例えばXの候補がA・B・C、Yの候補がB・C・D・Eなら、共通するのはB・Cの2頭です。X側を分母にすると2÷3=約66.7%、Y側なら2÷4=50%です。両集合の和集合A・B・C・D・Eを分母にする「共通頭数÷全体の異なる頭数」という定義なら2÷5=40%になります。
同じ材料でも数字が変わるので、率だけを出さず計算方法を書きます。
| 集合の比較方法 | この例の分子 | 分母 | 結果 | 用途 |
|---|---|---|---|---|
| X候補のうち共通 | 2 | 3 | 66.7% | Xの候補がどれだけ残るか |
| Y候補のうち共通 | 2 | 4 | 50.0% | Yの候補がどれだけ残るか |
| 和集合に対する共通 | 2 | 5 | 40.0% | 候補全体の重なりを見る |
この表で優劣を決める必要はありません。目的に合う定義を一つ選び、同じ方法で複数レースを記録することが大切です。「一致率」という名前だけでは何を分母にしたか分からないため、台帳には共通頭数と双方の候補頭数も残します。
同順位と欠測を含むときの計算を変える
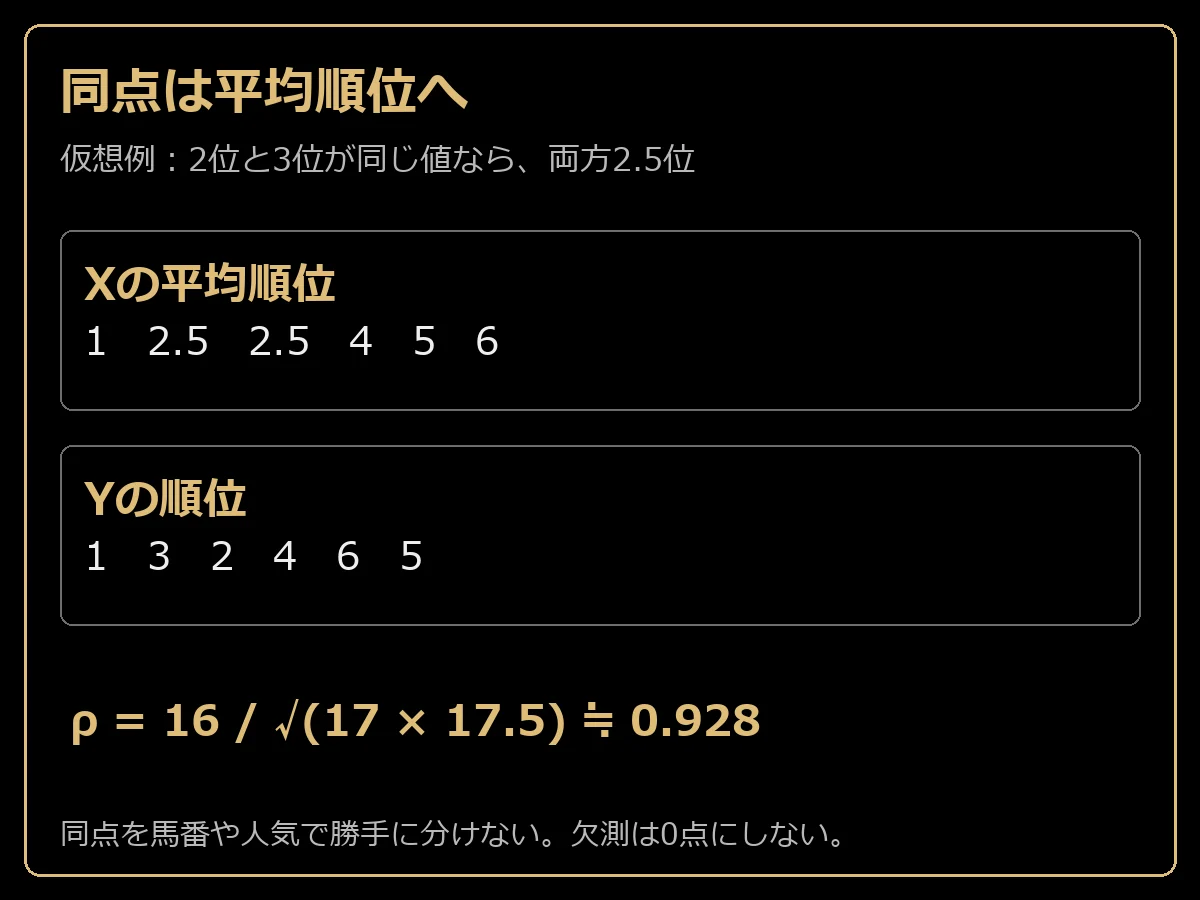
同じ指数の馬を馬番で勝手に順位付けしない
同じ値が並んだとき、表示順だけで2位・3位と分けると、本来ない差を作ってしまいます。2位と3位を占める2頭が同点なら、両方を平均の2.5位にします。これを平均順位と呼びます。次の馬は4位となり、2.5位の次を3位に詰めません。
仮想のX値を90、85、85、75、70、65とすると、順位は1、2.5、2.5、4、5、6です。順位の合計は依然として21です。合計だけで全ての間違いを発見できるわけではありませんが、2.5、2.5の後を3にしてしまったような転記ミスの点検に使えます。
| 馬 | X値 | X平均順位 | Y順位 | 平均との差X | 平均との差Y |
|---|---|---|---|---|---|
| A | 90 | 1 | 1 | -2.5 | -2.5 |
| B | 85 | 2.5 | 3 | -1 | -.5 |
| C | 85 | 2.5 | 2 | -1 | -1.5 |
| D | 75 | 4 | 4 | .5 | .5 |
| E | 70 | 5 | 6 | 1.5 | 2.5 |
| F | 65 | 6 | 5 | 2.5 | 1.5 |
平均順位同士の相関で計算する
同順位がある場合は、前章の短い二乗差の式をそのまま使わず、平均順位に直した2列の相関を求めます。この例では両方の順位平均は3.5です。各行の平均との差を掛けて合計し、それぞれの平均との差の二乗和の積の平方根で割ります。
表の平均との差の積は6.25、0.5、1.5、0.25、3.75、3.75で合計16です。Xの偏差平方和は17、Yは17.5なので、16÷√(17×17.5)=約0.928になります。数字が細かく見えますが、手順は平均順位を作って普通の相関を取るだけです。
独自の同点優先ルールで順序を作る必要はありません。
Rの公式資料でも、スピアマンの相関は順位へ変換した値の相関として説明され、欠測の指定により対象の取り方が変わります。R公式のcor資料の定義に沿い、使用した平均順位と対象頭数を保存してください。全頭が同じ値で順位に変動がない場合は、通常の相関は計算できません。
0として埋めないことが重要です。
欠測を最低評価や0点として埋めない
指数が空欄の馬は、弱いから値がないとは限りません。初条件、出走歴の少なさ、取得失敗など理由が異なります。Xに値がありYに値がない馬へ、勝手に最下位を付けると、評価の差とデータ不足が混ざります。両方ある馬だけを比較する場合は、外した馬と理由を別に残します。
例えば6頭中FのY値がないなら、XとYがそろうA〜Eの5頭に絞って、それぞれを改めて1位から順位付けします。元の全頭順位のまま欠けた1行だけ消すと、比較対象内の順位と全頭内の順位が混在します。どちらを計算したかを曖昧にせず、基本は共通対象内で付け直します。
上位だけ取り出すと比較対象そのものが変わる
全6頭の中でXが上位3頭にしたA・B・Cだけを選び、その3頭でYとの順位相関を出しても、全頭の一致を調べたことにはなりません。Xが低く評価した馬を最初から除いているためです。その数字を出すなら「Xの上位3頭内での並びの比較」と対象を限定して説明します。
片方の上位馬だけを選ぶ方法と、両方の上位馬の和集合を選ぶ方法でも結果は異なります。どちらが正しいかは問いによりますが、計算する対象を結果に合わせて選ぶと比較の意味が失われます。最初の点検は出走予定全頭のうち両方の値がそろう馬で行い、その後に選択範囲を別表にする順序が扱いやすいでしょう。
全体の相関を出せないほど欠測が多い場合は、無理に一つの数字へまとめず、確認できた馬の順位対比表を出します。3頭の一致と18頭の一致を、同じ情報量の証拠として扱うことはできません。小さい標本では一頭の入れ替わりが大きく効くので、頭数と個別の行を見せる方が読み手に親切です。
順位の不一致を予想の確認作業へつなげる
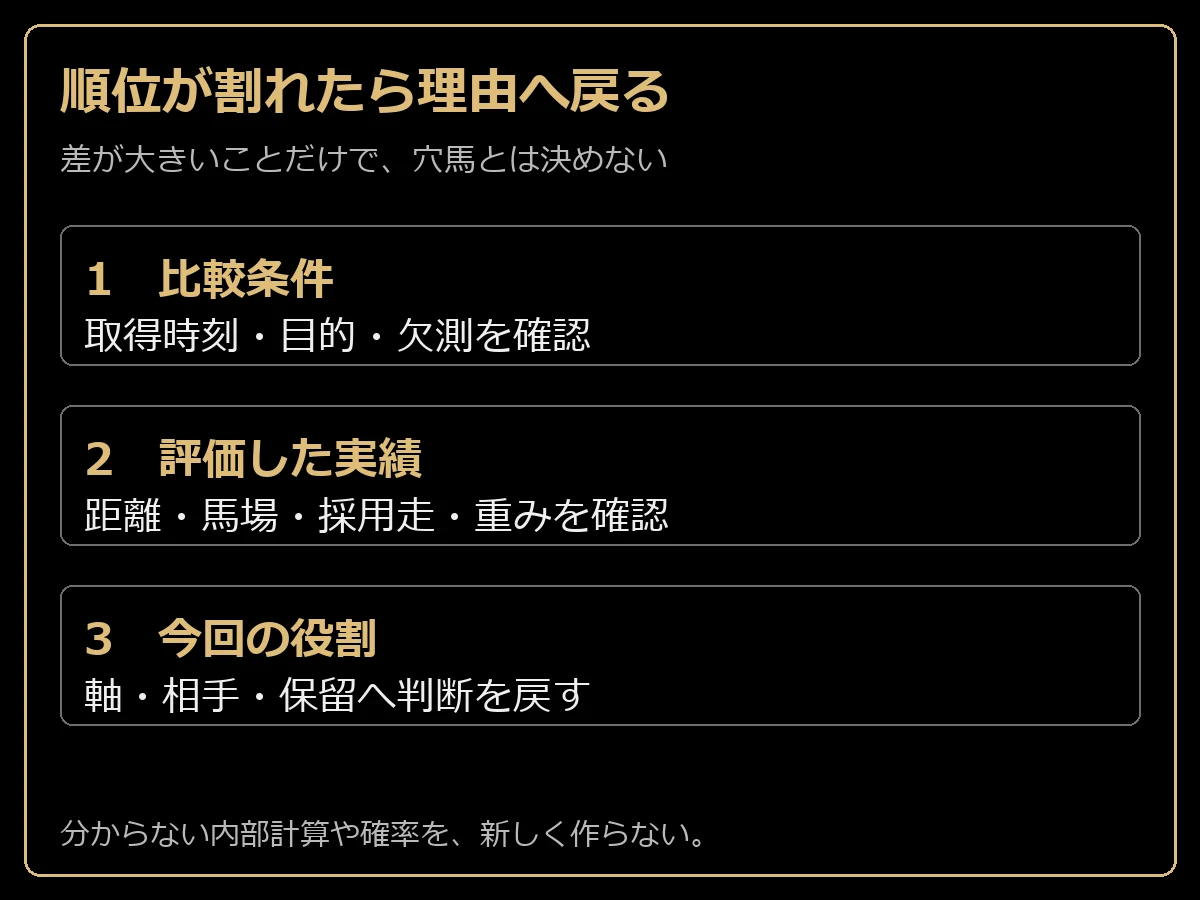
まず比較可能な条件の違いを探す
仮想のG馬は、直近3走のうち前走だけ得意な短距離で高い値を出し、2走前と3走前は長い距離で低い値だったとします。最高値を使う指数と、近走を平均する指数では順位が変わります。この差は計算の誤りではなく、どの実績を今回へ移すかという判断の差です。
今回が短距離なら前走の再現条件を、今回が延長なら前走の高さをどこまで残せるかを確認します。高く評価した方だけを採用するのではなく、それぞれが重視したレースを特定してください。都合のよい指数の乗り換えを繰り返すと、結果を見た後の説明が増え、検証できる規則が残りません。
| 順位が割れた理由の仮説 | 確認する資料 | 分かっても残る不確実性 |
|---|---|---|
| 近走の重みが違う | 対象走・重み・更新時刻 | 今回の条件への移し方 |
| 最高値と安定性が違う | 各走の値・ばらつき | 高値を再現できるか |
| 馬場補正が違う | 同日同条件の記録・定義 | 補正の内部計算が非公開の場合 |
| 距離適性を反映している | 今回と過去走の距離 | 未知条件の適性 |
| データ欠測がある | 空欄の理由・取得状況 | 欠測馬の真の評価 |
| 時点が違う | 保存時刻・発表時刻 | 片方に未反映の情報 |
仮説を一つ変えたときの順位を再確認する
一度に距離評価、近走重み、馬場評価、騎手評価を変えると、順位が変わった原因を追えません。自分の比較表では、まず一つの条件だけを変えた別表を作ります。元の表は上書きせず、変更した項目と理由を記録します。
例えば「前走の指数を除くとどうなるか」という感度確認をするなら、その操作を全対象馬に同じ規則で行います。特定の候補だけ都合の悪い前走を除くと、比較条件が不公平になります。除いた走がある馬とない馬では残る走数も変わるため、平均値の分母を併記してください。
この作業は優秀な指数を探す勝負ではありません。少しの条件差で軸が替わるのか、相手候補は変わらないのかを知るためのものです。1位と2位が入れ替わる一方で上位3頭が変わらないなら、軸の確定だけを保留して、候補集合の共通点を先に整理できます。
市場との違いを見る表は別にする
指数XとYの一致を調べた表へ、人気順位を混ぜて平均すると、評価の合意と市場の評価が同じ数字に押し込まれます。人気やオッズとの比較は別列に残し、いつのオッズかも記録します。指数上位で人気が低いことだけでは、割安な確率が分かったことにはなりません。
確率へ換算する仕組みが検証されていなければ、順位をそのまま勝率に直すことはできません。1位が必ず50%、2位が必ず25%などの割合を作らないでください。順位は順番を示しますが、差の大きさも、それぞれの勝つ確率も直接は示しません。
価格との関係は競馬の期待値で区別して扱っています。
保存できる比較台帳とよくある疑問
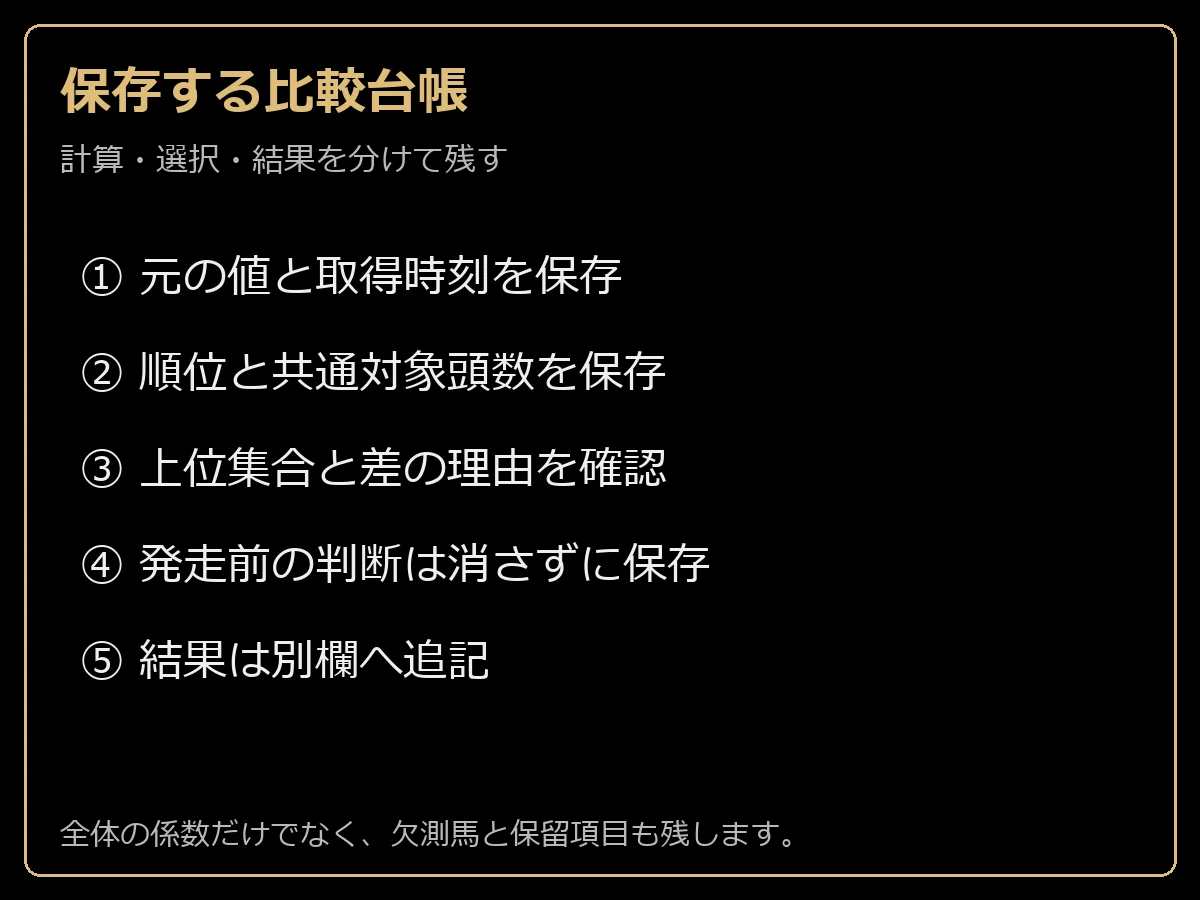
1レース分を同じ順序で保存する
実際に使う台帳は、最初から複雑な分析ソフトにする必要はありません。元の2列、順位2列、比較できた頭数、上位候補、差の理由、次回確認の七つが残れば、少なくとも計算と判断を区別して振り返れます。レース結果の列は発走前の表と別に追加します。
| 記録欄 | 保存する内容 | 今回の仮想例 |
|---|---|---|
| 対象 | 開催・場・レース・頭数 | 仮想6頭の比較 |
| 取得 | XとYの取得時刻・版 | 同じ発走前時刻 |
| 定義 | 方向・目的・対象走 | 高いほど高評価、同目的 |
| 計算 | 順位差二乗和・係数 | 4、0.885714… |
| 選択範囲 | 上位1/2/3頭の集合 | 上位1頭のみ不一致 |
| 確認理由 | 条件・欠測・重みの違い | A/B、D/Eの評価差 |
| 保留 | 不明な算出条件 | 独立性は未確認 |
後日の評価では、一致が高いレースだけを選んで成績を出さず、事前に決めた全対象を残します。一致が高い群と低い群の成績を比べるなら、群の境界、対象期間、券種、点数、購入規則を先に固定します。境界を何度も動かして最もよく見える結果だけを採用すると、後のレースで再現しない可能性が高まります。
全頭順位が一致していても、同じ1頭が凡走すれば双方の予想が同時に外れることがあります。指数間の一致は損失を分散させる証明ではありません。独立した予測誤差かを確かめるには、別期間の実測記録が必要です。指数の検証方法で、時点と期間分割の基本を確認してください。
複数レースの係数をまとめる前に見ること
仮想的に4レースを同じ手順で比較し、係数が0.886、0.429、−1.000、1.000だったとします。丸め前の値の単純平均は約0.329です。ただし「平均すると一致は0.329」と一つだけ書くと、完全逆順のレースと完全一致のレースが混ざっている事情が見えません。
各レースの係数をまず並べます。
| 仮想レース | 共通対象頭数 | 順位相関 | X上位3頭との共通数 | 次の確認 |
|---|---|---|---|---|
| R1 | 6 | 0.886 | 3 | 上位1頭の差 |
| R2 | 6 | 0.429 | 2 | 3位以下の入れ替わり |
| R3 | 6 | -1.000 | 0 | 評価の向きの誤入力がないか |
| R4 | 6 | 1.000 | 3 | 同じデータ由来か |
同じ頭数でも、R3のマイナスは興味深い結果に見えますが、最初に確認するのは入力方向です。低い時計ほど良い指標を高いほど良いものとして順位付けしていれば、機械的に逆転します。入力ミスの可能性を先に除き、それから設計の違いへ進みます。
意外な数値ほど、理由付けより点検が先です。
レースごとの頭数が違う場合、頭数の多いレースへ重みを付けて平均すれば必ず正しいというわけでもありません。レースを一単位として見るか、馬を一単位として見るかで集計の目的が変わります。日々の個人用記録なら、係数の分布、比較したレース数、共通対象頭数、欠測の割合を並べるだけでも十分に役立ちます。
異なるレースの「1位」をまとめた一列と、別指数の順位をまとめた一列へ普通の式を適用するのも、レース内順位の比較とは別の分析になります。同じ1位が何度も現れるので同順位処理が必要になり、各レースの出走頭数の違いも混じります。
まず各レース内で比較し、全体の集約は別の検討として扱ってください。
欠測率の差も一緒に残す
仮想の指数Xは全12頭に値があり、Yは8頭、Zは4頭にだけ値があるとします。X対Yは8頭、X対Zは4頭で計算できますが、それぞれの比較範囲が違います。係数だけでYとZのどちらがXに近いかを競わせると、どの馬を比べているかが抜け落ちます。
全12頭に対する取得率はYが8÷12=約66.7%、Zが4÷12=約33.3%です。これ自体は優劣や性能の数字ではなく、データがそろった範囲の説明です。共通の4頭にそろえてYとZを比較する補助表も作れますが、さらに対象が小さくなる点を明記します。
取得できなかった理由が、特定の初条件や少ない出走歴に集中している場合、対象を落とすこと自体が馬の構成を変えます。欠測を除けば公平になると決めつけず、どの種類の馬が残ったかも確認します。新馬戦を含む日と古馬の実績馬中心の日で、欠測の意味が同じとは限りません。
比較できた範囲が狭い日は、出走馬全体の合意を語ることを控えます。値がない馬には別の調査が必要という結論も、分析の有用な結果です。「計算ができた」ことを「レース全体を判断できた」ことへ広げない姿勢が、指数を使う際の基本になります。
発走前に残す確認の順番
- 同じ馬を一行に対応させ、両指数の取得時刻と目的を保存します。
- 高評価の向きをそろえ、同点には平均順位を付けます。
- 同順位がない場合だけ短い二乗差の式を使い、それ以外は順位列の相関を求めます。
- 共通対象の頭数と欠測馬を残し、全体の係数とは別に上位候補の重複を確認します。
- 順位差の大きい馬の採用走・距離・馬場・重み・版を読みます。
- 決定と保留を分け、結果が出た後も発走前の表を保存します。
ここまでの表を使い、Xを採用する案とYを採用する案で、実際に変わる候補だけを丸で囲んでみてください。全頭の比較をした後に意思決定の差へ戻ると、どの違いに追加調査の時間を使うべきかが分かります。DとEの相手評価だけが違うのか、軸のAとBまで違うのかでは、確認する優先順位も変わります。
また、候補を同じにしたまま購入額だけを変えた場合は、順位一致の検証とは別に配分の検証が必要です。順位の合意、候補の選択、券種、点数、金額を一つずつ分けて残すと、結果が悪かった際にも改善する場所を特定できます。
原因の異なる失敗を全て「指数が合わなかった」で片付けないようにしましょう。
相関が0.9なら、ほとんど当たる指数ですか?
いいえ。2種類の順位が近いことと、レースの着順が当たることは別です。比較相手も誤っていれば、両方が同じ方向へ間違うことがあります。的中率や回収率には、結果・券種・対象レース・点数・購入額の記録が別に必要です。
順位相関が低い指数を組み合わせれば分散できますか?
順位が違うだけでは予測誤差や損益が分散するとはいえません。評価目的が異なる、欠測が多い、時点が違うといった理由でも低くなります。組み合わせ規則を先に決め、別期間の結果で確かめる必要があります。
同じ値が並ぶとき、人気順で順位を決めてもよいですか?
指数自体の一致を比べるなら、人気で同点を割ると別の情報が混ざります。同点は平均順位にして計算するのが基本です。人気を同点処理に使う独自規則を検証したい場合は、純粋な指数順位とは別の手法として記録してください。
初出走などで指数がない馬は最下位にすればよいですか?
値がないことは最低能力を意味しません。空欄の理由を残し、共通対象だけの比較と、欠測馬の別評価を分けます。全頭のうち何頭を比較できたかを明示し、比較できなかった馬も出走している点を忘れないようにします。
順位の差を整理した後は、候補をどの券種のどの役割へ置くかを決めます。馬券の点数計算ツールでは、実際の馬番から重複を除いた点数と組み合わせを確認できます。順位を読む学習と点数の確認を組み合わせたい方は、解説記事一覧もご活用ください。
学んだ比較手順を、配信内容の確認へ
指数が全ての中央6コースは、各4週20,000円、メール配信です。対象となるレース、券種と配信内容を見本で比較し、ご自身が学びたい内容に合うコースをご確認ください。
相談窓口:shisuugasubete@gmail.com。料金や受付状況は現行の案内をご確認ください。
執筆:指数が全て。本文の仮想例は、実際の配信・購入・的中成績を示すものではありません。
コメントを残す